live chat

Databricks Certification Certified-Data-Engineer-Professional

Certified-Data-Engineer-Professional

시험 번호/코드: Certified-Data-Engineer-Professional

시험 이름: Databricks Certified Data Engineer Professional

업데이트: 2026-11-14

Q & A: 250문항

Certified-Data-Engineer-Professional 덤프무료샘플다운로드하기

PDF Version Demo Testing Engine Online Test Engine

PDF Version 가격: $129.00  $59.99


(Value Pack 50%OFF)

Certified-Data-Engineer-Professional덤프가 고객님께 드리는 약속

업데이트서비스 제공

Certified-Data-Engineer-Professional덤프는 Certified-Data-Engineer-Professional실제시험 변화의 기반에서 스케줄에 따라 업데이트 합니다. 만일 Certified-Data-Engineer-Professional시험문제가 변경된다면 될수록 7일간의 근무일 안에 Certified-Data-Engineer-Professional제품을 업데이트 하여 고객들이 테스트에 성공적으로 합격 할 수 있도록 업데이트 된 Databricks Certified Data Engineer Professional덤프 최신버전을 구매후 서비스로 제공해드립니다. 하지만 업데이트할수 없는 상황이라면 다른 적중율 좋은 덤프로 바꿔드리거나 Certified-Data-Engineer-Professional덤프비용을 환불해드립니다.

적중율 높은 덤프자료

Certified-Data-Engineer-Professional인기시험에 도전하고 싶으시다면 최강 시험패스율로 유명한 Databricks Certified Data Engineer Professional인기덤프로 시험공부를 해보세요. 시간절약은 물론이고 가격도 착해서 간단한 시험패스에 딱 좋은 선택입니다. Databricks Certified Data Engineer Professional 인기시험 출제경향을 퍼펙트하게 연구하여 Certified-Data-Engineer-Professional인기덤프를 출시하였습니다. Certified-Data-Engineer-Professional제품은 고객님의 IT자격증 취득의 앞길을 훤히 비추어드립니다.

저희 사이트에서 발췌한 Certified-Data-Engineer-Professional학습자료는 전문적인 IT인사들이 연구정리한 최신버전 Databricks Certified Data Engineer Professional시험에 대비한 공부자료입니다. Certified-Data-Engineer-Professional 덤프에 있는 문제만 이해하고 완벽하게 공부하신다면 Databricks Certified Data Engineer Professional최신시험을 한방에 패스하여 자격증을 쉽게 취득할수 있을것입니다.

한국어상담 가능

저희 사이트에서는 한국어 온라인상담과 메일상담 서비스를 제공해드립니다. Certified-Data-Engineer-Professional덤프에 관해 궁금한 점이 있으시면 온라인상담이나 메일로 상담 받으시면 상세한 답변을 받으수 있습니다. Certified-Data-Engineer-Professional덤프에 관한 모든 답을 드리기에 많은 연락 부탁드립니다.

불합격시 덤프비용 환불 약속

저희 사이트에서는 여러분이 Certified-Data-Engineer-Professional최신시험을 한방에 패스하도록 실제 시험문제에 대비한 Databricks Certified Data Engineer Professional 덤프를 발췌하여 저렴한 가격에 제공해드립니다.시험패스 못할시 덤프비용은 환불처리 해드리기에 고객님께 아무런 페를 끼치지 않을것입니다.

실제시험 출제방향에 초점을 맞춘 자료

Certified-Data-Engineer-Professional인기덤프는 실제시험문제 출제경향을 충분히 연구하여 제작한 완벽한 결과물입니다.실제시험문제가 바뀌면 덤프를 제일 빠른 시일내에 업데이트하도록 하기에 한번 구매하시면 1년동안 항상 가장 최신버전의 Certified-Data-Engineer-Professional 인기덤프자료를 제공받을수 있습니다.성공으로 향하는 길에는 많은 방법과 방식이 있습니다. Certified-Data-Engineer-Professional덤프는 실제시험 출제방향에 초점을 두어 연구제작한 시험준비 공부자료로서 높은 시험적중율과 시험패스율을 자랑합니다.국제적으로 승인해주는 IT자격증을 취득하시면 취직 혹은 승진이 쉬워집니다.

Databricks Certified-Data-Engineer-Professional 시험 요강 주제:

섹션목표
비용 및 성능 최적화- 쿼리 성능
  • 1. 비효율적인 조인 및 과도한 데이터 셔플링 식별
    • 2. 성능 병목 현상을 식별하기 위해 Query Profile 사용
      - 비용 최적화
      • 1. Unity Catalog 관리형 테이블이 운영 오버헤드를 줄이는 방법 이해
        - Delta 최적화
        • 1. 스트리밍 테이블의 제한 사항을 해결하고 대기 시간을 개선하기 위해 Change Data Feed 사용
          • 2. 데이터 건너뛰기(data skipping) 및 파일 프루닝(file pruning) 기법 적용
            • 3. 삭제 벡터(deletion vectors) 및 Liquid Clustering 이해
              데이터 모델링- 차원 모델링
              • 1. 분석 워크로드를 위한 차원 모델 설계
                - 확장 가능한 데이터 모델
                • 1. Liquid Clustering을 사용하여 데이터 레이아웃 최적화
                  • 2. Liquid Clustering과 파티셔닝 및 Z-Ordering 비교 이해
                    • 3. Delta Lake를 사용하여 확장 가능한 데이터 모델 설계 및 구현
                      데이터 거버넌스- Unity Catalog 권한
                      • 1. Unity Catalog 권한 상속 모델 이해
                        - 메타데이터 및 검색 가능성
                        • 1. 엔터프라이즈 데이터를 위한 설명 및 메타데이터 생성 및 유지 관리
                          데이터 보안 및 규정 준수 보장- 규정 준수
                          • 1. 개인 식별 정보(PII)를 감지하고 마스킹하는 파이프라인 구현
                            • 2. 데이터 보존 정책에 따른 데이터 영구 삭제(purging) 솔루션 개발
                              - 데이터 보안
                              • 1. 익명화 및 가명화 기법 적용
                                • 2. 작업 공간 객체를 보호하고 최소 권한 원칙을 적용하기 위해 ACL 사용
                                  • 3. 민감한 데이터를 위해 행 필터(row filters) 및 열 마스크(column masks) 사용
                                    디버깅 및 배포- CI/CD 배포
                                    • 1. Databricks Asset Bundles를 사용하여 Databricks 리소스 빌드 및 배포
                                      • 2. Databricks Git Folders를 사용하여 Git 기반 CI/CD 워크플로 통합
                                        - 디버깅 및 트러블슈팅
                                        • 1. 오류를 분석하고 실패한 작업 실행 복구
                                          • 2. 진단을 위해 Spark UI, 클러스터 로그, 시스템 테이블 및 쿼리 프로필 사용
                                            • 3. 디버깅을 위해 Lakeflow Spark Declarative Pipelines 이벤트 로그 및 Spark UI 사용
                                              데이터 공유 및 페더레이션- Delta Sharing
                                              • 1. Databricks 간(Databricks-to-Databricks) 공유 구성
                                                • 2. 외부 컴퓨팅 플랫폼과 실시간 Lakehouse 데이터 공유
                                                  • 3. 오픈 공유 프로토콜을 사용하여 외부 플랫폼과의 공유 구성
                                                    - Lakehouse Federation
                                                    • 1. 적절한 거버넌스를 갖춘 Lakehouse Federation 구성
                                                      모니터링 및 알림- 모니터링
                                                      • 1. 워크로드 모니터링을 위해 Query Profiler 및 Spark UI 사용
                                                        • 2. 모니터링을 위해 Lakeflow Spark Declarative Pipelines 이벤트 로그 사용
                                                          • 3. 리소스, 비용, 감사 및 워크로드 모니터링을 위해 시스템 테이블 사용
                                                            • 4. 작업 및 파이프라인 모니터링을 위해 Databricks REST API 및 CLI 사용
                                                              - 알림
                                                              • 1. 작업 상태 및 성능 문제를 위해 Lakeflow Jobs 알림 구성
                                                                • 2. 데이터 품질 모니터링을 위해 SQL Alerts 사용
                                                                  Python 및 SQL을 사용한 데이터 처리 코드 개발- 개발을 위한 Python 및 도구 사용
                                                                  • 1. Databricks Asset Bundles에 최적화된 확장 가능한 Python 프로젝트 구조 설계 및 구현
                                                                    • 2. 서드파티 라이브러리 설치 및 종속성 관리와 트러블슈팅
                                                                      • 3. Pandas/Python UDF를 사용한 사용자 정의 함수(UDF) 개발
                                                                        - ETL 파이프라인 구축 및 테스트
                                                                        • 1. UI, API 및 CLI를 통해 Jobs를 사용한 ETL 워크로드 생성 및 자동화
                                                                          • 2. Lakeflow Spark Declarative Pipelines 및 Auto Loader를 사용하여 프로덕션 환경에 적합한 배치 및 스트리밍 파이프라인 구축
                                                                            • 3. 데이터 처리 코드를 위한 단위 및 통합 테스트 개발
                                                                              • 4. 스트리밍 테이블과 구체화된 뷰(materialized views) 비교
                                                                                • 5. 변경 데이터 캡처(CDC)를 위해 APPLY CHANGES API 사용
                                                                                  • 6. 파이프라인 구성 요소에서 제어 흐름 연산자 사용
                                                                                    • 7. Spark Structured Streaming과 Lakeflow Spark Declarative Pipelines 비교
                                                                                      • 8. 환경, 종속성, 메모리 및 재시도 동작 구성
                                                                                        데이터 수집 및 획득- 데이터 수집 파이프라인 설계 및 구현
                                                                                        • 1. Delta Lake, Parquet, ORC, Avro, JSON, CSV, XML, Text 및 Binary 데이터 수집
                                                                                          • 2. 메시지 버스 및 클라우드 스토리지로부터 데이터 수집
                                                                                            • 3. Delta를 사용하여 배치 및 스트리밍 데이터를 위한 추가 전용(append-only) 파이프라인 구축
                                                                                              데이터 변환, 정제 및 품질- 고급 데이터 변환
                                                                                              • 1. 대규모 데이터 세트에 윈도우 함수, 조인 및 집계 적용
                                                                                                • 2. 효율적인 Spark SQL 및 PySpark 변환 작성
                                                                                                  - 데이터 품질
                                                                                                  • 1. 유효하지 않은 데이터를 위한 데이터 격리(quarantining) 프로세스 개발
                                                                                                    • 2. Lakeflow Spark Declarative Pipelines 또는 Auto Loader를 사용하여 데이터 품질 제어 적용

                                                                                                      최신 Databricks Certification Certified-Data-Engineer-Professional 무료샘플문제

                                                                                                      문제 #1
                                                                                                      A DLT pipeline includes the following streaming tables:
                                                                                                      Raw_lot ingest raw device measurement data from a heart rate tracking device.
                                                                                                      Bpm_stats incrementally computes user statistics based on BPM measurements from raw_lot.
                                                                                                      How can the data engineer configure this pipeline to be able to retain manually deleted or updated records in the raw_iot table while recomputing the downstream table when a pipeline update is run?

                                                                                                      A. Set the pipelines, reset, allowed property to false on bpm_stats
                                                                                                      B. Set the skipChangeCommits flag to true on bpm_stats
                                                                                                      C. Set the SkipChangeCommits flag to true raw_lot
                                                                                                      D. Set the pipelines, reset, allowed property to false on raw_iot


                                                                                                      문제 #2
                                                                                                      The data governance team is reviewing code used for deleting records for compliance with GDPR. They note the following logic is used to delete records from the Delta Lake table named users.
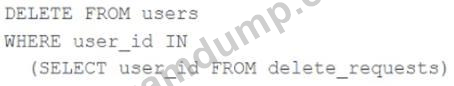
                                                                                                      Assuming that user_id is a unique identifying key and that delete_requests contains all users that have requested deletion, which statement describes whether successfully executing the above logic guarantees that the records to be deleted are no longer accessible and why?

                                                                                                      A. No; the Delta cache may return records from previous versions of the table until the cluster is restarted.
                                                                                                      B. No; files containing deleted records may still be accessible with time travel until a vacuum command is used to remove invalidated data files.
                                                                                                      C. No; the Delta Lake delete command only provides ACID guarantees when combined with the merge into command.
                                                                                                      D. Yes; the Delta cache immediately updates to reflect the latest data files recorded to disk.
                                                                                                      E. Yes; Delta Lake ACID guarantees provide assurance that the delete command succeeded fully and permanently purged these records.


                                                                                                      문제 #3
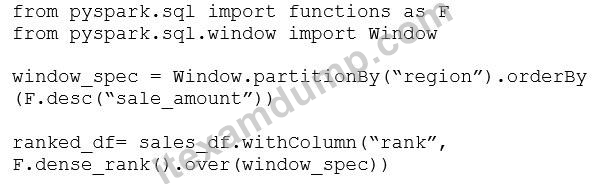
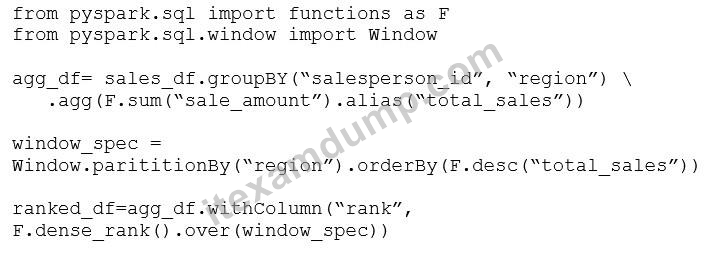
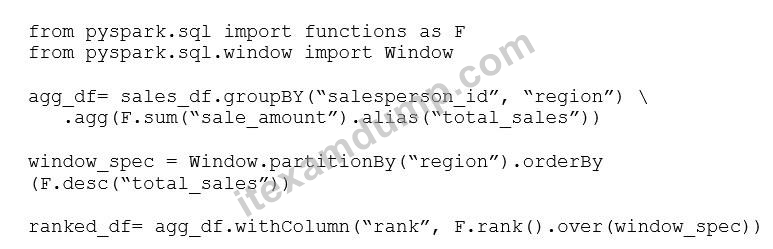
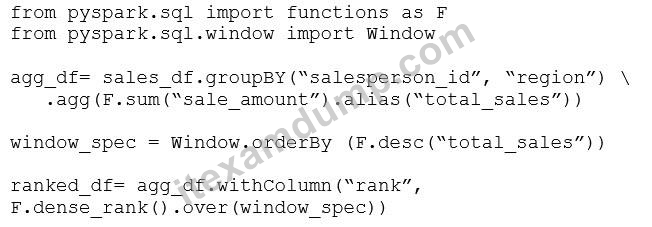
                                                                                                      A data engineer is analyzing a large, partitioned retail dataset in Databricks, where each row represents a sale made by a salesperson. The dataset contains millions of records with the following schema:
                                                                                                      sales_df: [salesperson_id: string, region: string, sale_amount: double, sale_date: date] The data engineer needs to generate a DataFrame that ranks salespeople within each region based on their total cumulative sales, with the highest seller ranked as 1. If multiple salespeople have the same total sales, they should share the same rank.
                                                                                                      The data engineer wants to implement this logic using a PySpark window function and the dense_rank () function.
                                                                                                      Which code snippet will perform this ranking?

                                                                                                      A.
                                                                                                      B.
                                                                                                      C.
                                                                                                      D.

                                                                                                      문제 #4
                                                                                                      The data science team has created and logged a production model using MLflow. The model accepts a list of column names and returns a new column of type DOUBLE.
                                                                                                      The following code correctly imports the production model, loads the customers table containing the customer_id key column into a DataFrame, and defines the feature columns needed for the model.
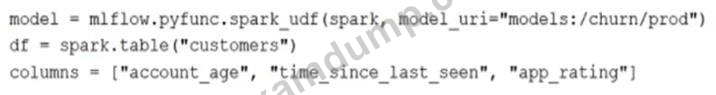
                                                                                                      Which code block will output a DataFrame with the schema "customer_id LONG, predictions DOUBLE"?

                                                                                                      A. model.predict(df, columns)
                                                                                                      B. df.map(lambda x:model(x[columns])).select("customer_id, predictions")
                                                                                                      C. df.select("customer_id", model(*columns).alias("predictions"))
                                                                                                      D. df.select("customer_id", pandas_udf(model, columns).alias("predictions"))
                                                                                                      E. df.apply(model, columns).select("customer_id, predictions")


                                                                                                      문제 #5
                                                                                                      A data engineer is configuring a Databricks Asset Bundle to deploy a job with granular permissions.
                                                                                                      The requirements are:
                                                                                                      - Grant the data-engineers group CAN_MANAGE access to the job.
                                                                                                      - Ensure the auditors' group can view the job but not modify/run it.
                                                                                                      - Avoid granting unintended permissions to other users/groups.
                                                                                                      How should the data engineer deploy the job while meeting the requirements?

                                                                                                      A. resources:
                                                                                                      jobs:
                                                                                                      my-job:
                                                                                                      name: data-pipeline
                                                                                                      tasks: [...]
                                                                                                      job: [...]
                                                                                                      permissions:
                                                                                                      - group_name: data-engineers
                                                                                                      level: CAN_MANAGE
                                                                                                      permissions:
                                                                                                      - group_name: auditors
                                                                                                      level: CAN_VIEW
                                                                                                      B. permissions:
                                                                                                      - group_name: data-engineers
                                                                                                      level: CAN_MANAGE
                                                                                                      - group_name: auditors
                                                                                                      level: CAN_VIEW
                                                                                                      resources:
                                                                                                      jobs:
                                                                                                      my-job:
                                                                                                      name: data-pipeline
                                                                                                      tasks: [...]
                                                                                                      job_clusters: [...]
                                                                                                      C. resources:
                                                                                                      jobs:
                                                                                                      my-job:
                                                                                                      name: data-pipeline
                                                                                                      tasks: [...]
                                                                                                      job_clusters: [...]
                                                                                                      permissions:
                                                                                                      - group_name: data-engineers
                                                                                                      level: CAN_MANAGE
                                                                                                      - group_name: auditors
                                                                                                      level: CAN_VIEW
                                                                                                      D. resources:
                                                                                                      jobs:
                                                                                                      my-job:
                                                                                                      name: data-pipeline
                                                                                                      tasks: [...]
                                                                                                      job_clusters: [...]
                                                                                                      permissions:
                                                                                                      - group_name: data-engineers
                                                                                                      level: CAN_MANAGE
                                                                                                      - group_name: auditors
                                                                                                      level: CAN_VIEW
                                                                                                      - group_name: admin-team
                                                                                                      level: IS_OWNER


                                                                                                      질문과 대답:

                                                                                                      문제 #1
                                                                                                      정답: D
                                                                                                      문제 #2
                                                                                                      정답: B
                                                                                                      문제 #3
                                                                                                      정답: B
                                                                                                      문제 #4
                                                                                                      정답: C
                                                                                                      문제 #5
                                                                                                      정답: C

                                                                                                      Certified-Data-Engineer-Professional 에 관계 된 시험
                                                                                                      Associate-Developer-Apache-Spark-3.5 - Databricks Certified Associate Developer for Apache Spark 3.5 - Python
                                                                                                      Associate-Developer-Apache-Spark - Databricks Certified Associate Developer for Apache Spark 3.0 Exam
                                                                                                      Databricks-Certified-Data-Engineer-Associate - Databricks Certified Data Engineer Associate Exam
                                                                                                      Databricks-Certified-Data-Engineer-Professional - Databricks Certified Data Engineer Professional Exam
                                                                                                      Databricks-Certified-Data-Engineer-Professional-KR - Databricks Certified Data Engineer Professional Exam (Databricks-Certified-Data-Engineer-Professional Korean Version)
                                                                                                      다른 Databricks 시험
                                                                                                      Data Analyst
                                                                                                      Databricks Certification
                                                                                                      ML Data Scientist
                                                                                                      Context Engineer
                                                                                                      Generative AI Engineer
                                                                                                      ITExamDump의 제품으로 GO GO GO !
                                                                                                       자격증의 중요성:경쟁율이 심한 IT시대에 인증시험을 패스함으로 IT업계 관련 직종에 종사하고자 하는 분들에게는 아주 큰 가산점이 될수 있고 자신만의 위치를 보장할수 있으며 더욱이는 한층 업된 삶을 누릴수 있을수도 있습니다.
                                                                                                       ITExamDump 제품의 가치:ITExamDump에는 IT인증시험의 최신 학습가이드가 있습니다. ITExamDump의 IT전문가들이 자신만의 경험과 끊임없는 노력으로 최고의 학습자료를 작성해 여러분들이 시험에서 패스하도록 도와드립니다.
                                                                                                       무료샘플 받아보기:관심있는 인증시험과목 덤프의 무료샘플을 원하신다면 덤프구매사이트의 PDF Version Demo 버튼을 클릭하고 메일주소를 입력하시면 바로 다운받아 덤프의 일부분 문제를 체험해 보실수 있습니다.
                                                                                                       완벽한 서비스 제공:ITExamDump는 한국어로 온라인상담과 메일상담을 받습니다. 덤프구매후 일년동안 무료 업데이트 서비스를 제공해드리며 구매일로 부터 60일내에 시험에서 떨어지는 경우 덤프비용 전액을 환불해드려 고객님의 부담을 덜어드립니다.
                                                                                                      우리와 연결하기:  
                                                                                                       [email protected]
                                                                                                       [email protected]

                                                                                                      Free Demo Download

                                                                                                      인기인증
                                                                                                      Adobe
                                                                                                      Alcatel-Lucent
                                                                                                      Avaya
                                                                                                      BEA
                                                                                                      CheckPoint
                                                                                                      CIW
                                                                                                      CompTIA
                                                                                                      CWNP
                                                                                                      EC-COUNCIL
                                                                                                      EXIN
                                                                                                      Hitachi
                                                                                                      ISC
                                                                                                      ISEB
                                                                                                      더 많은 인증 보기
                                                                                                      Reviews  상품후기
                                                                                                      Certified-Data-Engineer-Professional 시험은 모두 itexamdump에서 구한 덤프와 똑같게 나와서 합격했어요.
                                                                                                      사이트 운영자님은 Databricks자격증시험을 계속 봐야 하는 저에게 큰 힘이 된답니다.

                                                                                                      보물섬

                                                                                                      생각보다 Certified-Data-Engineer-Professional덤프에서 문제가 많이 나와서 너무 좋았어요.
                                                                                                      Certified-Data-Engineer-Professional시험을 덤프공부 한덕에 가뿐히 패스하고 몇자 적습니다.

                                                                                                      통키왕 피구

                                                                                                      Databricks Certified-Data-Engineer-Professional 시험 그냥 덤프 외우시면 됩니다.
                                                                                                      시험문제가 아직 바뀌지 않아서 덤프대로 답 찍으면 합격할수 있어요.^^

                                                                                                      다운로드

                                                                                                      ※면책사항

                                                                                                      시험문제 변경시간은 예측불가하기에 상품후기는 구매시 간단한 참고로만 보시면 됩니다.구체적인 덤프적중율은 온라인서비스나 메일로 문의해보시고 구매결정을 하시면 됩니다.본 사이트는 상품후기에 따른 이익 혹은 손해 또는 상품후기로 인한 회원사이의 모순에 관해서는 일체 책임을 지지 않습니다.